ボイスチェンジャー
そもそも音声をどのように用意するかという知識がなく、調べてみると以下の方法
- 方法1)AIが文章を読み上げる音声合成(TTS)
- 方法2)ボイスチェンジャー
今回は説明する練習をしたかったのとソースは肉声で準備して、少しでもAIコンテンツ感をなくしたいということで、ボイスチェンジャーを試してみました
自分の話すスピードや間の取り方、抑揚を活かしながら、地声とは異なる声で動画を公開できます。
AI音声合成とAIボイスチェンジャーの違い
| 比較項目 | AI音声合成(TTS) | AIボイスチェンジャー |
|---|---|---|
| 入力 | テキスト | 自分の音声 |
| 話す速度・間 | ソフト側で調整 | 自分の話し方を反映 |
| 抑揚 | AIが生成 | 元の音声を一定程度反映 |
インストール
公式サイト https://www.voicemod.net/ から「DOWNLOAD FOR FREE」でダウンロードする(非公式の配布サイトはマルウェアの危険があるので使わない)
他のアプリで使う
アプリのマイク(入力デバイス)を「Voicemod」と名前の付いた仮想マイクに切り替える。
- Discord — ユーザー設定 → 音声・ビデオ → 入力デバイス
- Zoom — 設定 → オーディオ → マイク
- OBS — 音声入力キャプチャのデバイス
変換した声を録音する(QuickTime Player)
- Voicemodを起動したまま、使うボイスを選んでおく
- QuickTime Playerで「ファイル」→「新規オーディオ収録」を選ぶ
- 録音ボタン横の「⌄」から、マイクを「Voicemod」に切り替える(内蔵マイクのままだと地声で録音される)
- 録音して停止し、「ファイル」→「保存」で保存する(.m4a)
参考youtube
Remotionまでの制作フロー
Remotionの始め方(Remotion公式)
https://www.remotion.dev/docs
Remotion環境構築
- 約1分の縦型動画(1080×1920、30fps)を作る
- ナレーションはQuickTimeで録音し、Voicemodで声を変換した .m4a を使う
- 字幕はWhisper.cppで自動生成し、台本と照らし合わせて誤字だけ直す方針
- MacBook Air(M4)
- Node.js v24.13.1(
node -vで確認。v20以上なら問題なし)
- 個人や3人以下のチームなら無料
npx create-video@latestOk to proceed?→y(作成ツールを一時的にダウンロードする確認)- テンプレート →
TikTok- 縦型で、単語ごとの字幕アニメーションとWhisper.cppによる書き起こしが入っている
- 名前はTikTokだが、YouTubeショートやリールにもそのまま使える
- ディレクトリ名 → デフォルトの
my-videoを採用(~/dev/personal/my-video)- 1つのプロジェクトに複数の動画を入れられるので、汎用的な名前で作り、今後の動画もここに追加していく
remotionちょうどの名前は、Remotion本体のパッケージ名と衝突する恐れがあるので避ける- フォルダ名は後からリネームできる
- Add agent skills →
Install all skills- AIコーディングツール向けのRemotionガイドが
.agents/skills/に入る。動画そのものには影響しない
- AIコーディングツール向けのRemotionガイドが
- Open in Cursor? → 好みで選ぶ
この方法では、動画のレイアウトやアニメーションをReact・TypeScriptで実装しながら、技術をわかりやすく説明する練習もできます。
一度動画のテンプレートを作成すれば、次回以降は台本・音声・表示テキストを変更するだけで、同じデザインの動画を制作しやすくなります。
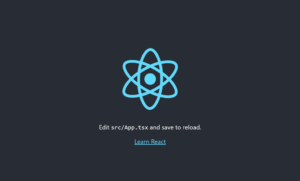
npm run dev でサーバー起動してブラウザで以下の画面が表示
Remotion Studioでサンプルを確認する
npm run dev で Remotion Studio を起動し、ブラウザで http://localhost:3000 を開く。
- 左の一覧が「コンポジション」(動画1本分の設定)
- 中央でプレビューを再生できる
- 「No caption file found」は、字幕ファイルがまだ無いというメッセージ
テンプレートのファイル構成
src/Root.tsx:コンポジションの一覧。<Composition>1つが、Studioの左の一覧の1項目になるsrc/CaptionedVideo/:サンプル動画の本体(撮影した動画の上に字幕を重ねる作り)sub.mjs:字幕生成スクリプト。npm run create-subtitlesで実行するwhisper-config.mjs:Whisperのモデルと言語の設定public/:音声や画像などの素材を置く場所。コードからはstaticFile("ファイル名")で参照する
日本語の音声で使うための修正
音声ファイル(.m4a)も書き起こしの対象にする
テンプレートの sub.mjs が対象にしているのは .mp4 / .webm / .mkv / .mov だけ。.m4a を置いても、エラーが出ないまま飛ばされるので気づきにくい。
拡張子の判定に、音声ファイルを追加する。
const MEDIA_EXTENSIONS = [".mp4", ".webm", ".mkv", ".mov", ".m4a", ".mp3", ".wav"];

const extension = path.extname(fullPath).toLowerCase();
if (!MEDIA_EXTENSIONS.includes(extension)) {
  return;
}
書き起こし済みかどうかを判定している部分も、同じ4つの拡張子しか見ていないので、あわせて直す。
Whisperを日本語用にする
初期設定は英語専用のモデル(medium.en)と言語(en)。日本語では、.en の付かないモデルを使う。
export const WHISPER_MODEL = "large-v3";
export const WHISPER_LANG = "ja";large-v3はディスクを約2.9GB使う。メモリは実行中だけ約4.7GB使う(メモリ16GBのM4 MacBook Airで問題なく動いた)- ボイスチェンジャーで変えた声は誤認識が増えやすいので、精度の高いモデルを選んだ
large-v3-turboは Whisper.cpp 1.7.2 以上が必要で、テンプレートが使う 1.6.0 では使えない
素材の置き場所
1つのプロジェクトに複数の動画を入れる前提で、動画ごとにフォルダを分ける。
src/videos/<動画名>/      コンポジションのコード、台本(script.md)
public/<動画名>/ 音声(narration.m4a)、字幕データ(narration.json)- ファイル名は半角英数字とハイフンだけにする(日本語やスペースは、コマンドで扱うときのトラブルの元)
- 自分の声が入った音声は、
.gitignoreで Git の管理対象から外しておくと安心
public/**/*.m4a
public/**/*.mp3
public/**/*.wav
Whisper.cppで字幕データを作る
npm run create-subtitles -- public/<動画名>/narration.m4a- ファイルを指定しないと
public/の中を全部処理するので、サンプル動画まで書き起こしてしまう - 初回は、Whisper.cpp のビルドとモデルのダウンロード(約3GB)で時間がかかる
- 音声と同じ名前の
.jsonができる(各フレーズの文章と、開始・終了の時刻)
日本語での書き起こし結果
- 単語ごとではなく、読点や句点で区切られたフレーズごとの結果になった。1フレーズずつ表示する字幕にはちょうどよい
- ボイスチェンジャーの声では誤認識があった(例:「なぜ生まれたのか」が「なぜ巻いたのか」になる)
- 台本と照らし合わせて、JSONの文章(
text)だけを直す。タイミングはWhisperの結果をそのまま使う - 録音で台本と違う言い方をした部分は、実際に話した言葉に合わせる(音と字幕が違うと、見る人が違和感を持つ)
- 句読点はデータには残し、画面に表示するときだけ消す(見た目を後から変えやすい)
動画のコンポジションを作る
テンプレートのサンプルは「撮影した動画+字幕」が前提の作り。今回のように映像がなく音声だけの動画では、新しくコンポジションを作るほうが素直。
画面は次の3層で組み立てる。
- 背景・図・テキストのアニメーション(すべてコードで作る)
- 字幕
- ナレーション音声
使うパッケージを追加する。
npx remotion add @remotion/media @remotion/google-fonts実装のポイント
- 音声は
@remotion/mediaの<Audio>で流す - 動画の長さは
calculateMetadataで音声の長さから自動で決める。字幕のJSONもここで読み込む - 日本語フォントは
@remotion/google-fontsの Noto Sans JP を使う - 字幕の改行は CSS の
word-break: auto-phraseで、文節の切れ目に入る(要素にlang="ja"を付けないと効かない) - 字幕は、各SNSのUI(右側のボタン、下部の説明文)に重ならない位置に置く
アニメーションは動画ファイルを置くのではなく、フレーム番号から計算してコードで作る。
const frame = useCurrentFrame(); // 今のフレーム番号
const opacity = interpolate(frame, [0, 30], [0, 1]); // 30フレーム(1秒)でフェードイン

return <div style={{ opacity }}>はじめまして</div>;
つまずいたところ
<AbsoluteFill> は幅と高さが100%に固定されているので、top で位置をずらすと、要素が画面の下にはみ出る。位置を指定したい要素は、普通の <div> に position: "absolute" を付けて置く。
見た目の確認は、静止画を書き出すと手早くできる。
npx remotion still <コンポジションID> out/still.png --frame=60MP4に書き出す
npx remotion render <コンポジションID> out/<動画名>.mp4- 映像はH.264、音声はAACで書き出される。YouTubeショート・TikTok・Instagramリールにそのまま投稿できる
- M4 MacBook Airでは、約85秒の動画が約40秒で書き出せた
out/は最初から.gitignoreに入っている
YouTubeショートに投稿する
- 縦型で3分以内の動画は、自動でショートとして扱われる。
#shortsは付けなくてもよい - タイトルは画面に1〜2行しか出ないので、大事な言葉を前に置く
- 説明文のハッシュタグのうち、最初の3つがタイトルの上に表示される
- 視聴者は「子ども向けではない」、カテゴリは「教育」など
- 「改変または合成されたコンテンツ」の申告は、実在の人物や出来事と見間違えるようなリアルな改変が対象